Tercera clase del DP-600 con Alex Ayala y NamasData, y esta semana viene doble. Dos partes: quién puede entrar en un área de trabajo de Fabric y qué puede hacer, y Power Query trabajando en la nube.
Cuatro roles. El más bajo que baste.
Un área de trabajo es la «carpeta» compartida del equipo. Quien entra lo hace con uno de estos cuatro roles:
- VisorVe el contenido sin modificarlo. Y puede leer datos con T-SQL por el punto de conexión.
- ColaboradorCrea y edita elementos. Ya puede usar Spark y las API de OneLake.
- MiembroAñade personas con permisos iguales o menores y vuelve a compartir.
- AdministradorEl único que actualiza o elimina el área de trabajo.
La idea es dar siempre el rol más restrictivo que cumpla lo que se necesita. Y una buena práctica: asignar los roles a grupos de seguridad, no a personas. Si alguien cambia de departamento, cambias el grupo y no cada elemento.
Compartir un Lakehouse no abre todo el área
Puedes compartir un Lakehouse concreto sin dar acceso al área de trabajo entera. Al hacerlo aparecen dos casillas de lectura, y cada una abre una puerta distinta:
☑ Casilla SQL
- Consulta las tablas con T-SQL
- Desde SSMS u otra herramienta
- No ve los archivos de Files
☑ Casilla Spark
- Lee con un cuaderno
- O con las API de OneLake
- Ve tablas y también archivos
Y ninguna de las dos da permiso de escritura: compartir es solo leer.
Power Query, con destino
Un flujo de datos Gen2 es el Power Query de siempre, pero en Fabric y con una diferencia clave: el resultado no se queda dentro de un informe, se guarda como tabla Delta en el Lakehouse (o en un Warehouse) para que lo use quien lo necesite.
Para practicarlo creé mi flujo df_compras: tres CSV de compras en Files, limpieza, la categoría de cada producto y destino al Lakehouse. Encaja en la arquitectura medallón: bronce (los archivos tal como llegan), plata (limpios, en Delta) y oro (listos para el modelo).
Crear un flujo no lo ejecuta. Es escribir la receta. Sin «Guardar y ejecutar», no se cocina nada.
Un clásico que también llega a Fabric: 7.9 → 79
Lo veo siempre en mis clases de Power BI: el CSV trae el importe con punto decimal y, con la configuración regional de España, el punto separa los miles. El 7.9 se convierte en 79. En Fabric se arregla igual: Tipo de cambio → Usar configuración regional → Número decimal → English (United States).
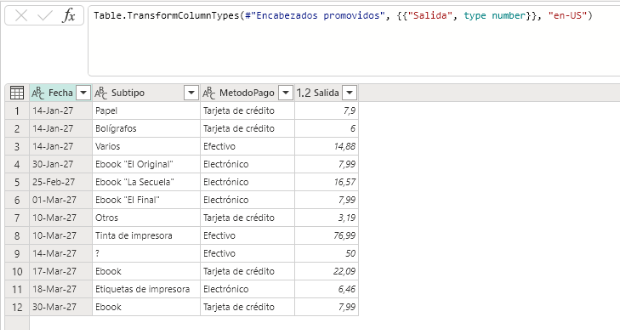
La clave: se elige la configuración del dato, no la que te gustaría recibir.
Combinar consultas: ¿qué filas quieres?
Hay seis tipos de combinación: externa izquierda, externa derecha, externa completa, interna, anti izquierda y anti derecha. Se elige según las filas que quieres que queden. Las dos más habituales:
- Externa izquierdaTodo lo de la primera tabla; lo que no tiene pareja queda vacío.
- InternaSolo lo que está en las dos a la vez.
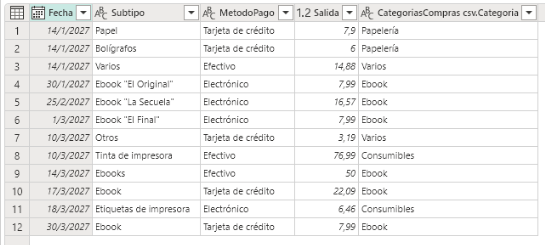
En mi práctica, «Ebooks» en plural no encontraba su pareja «Ebook»: 11 de 12. Con la coincidencia aproximada y su umbral de similitud, 12 de 12.
Plegado de consultas: que trabaje el origen
Power Query intenta traducir los pasos a SQL para que sea el Lakehouse quien haga el trabajo y devuelva solo las filas filtradas. Lo que no sabe traducir lo hace él después, con todos los datos ya cargados.
Por eso el orden importa: primero el filtro, y al final lo que no se puede traducir (como poner en mayúsculas cada palabra). Con clic derecho en el paso → Ver consulta de origen de datos aparece el SQL que escribe Power Query:
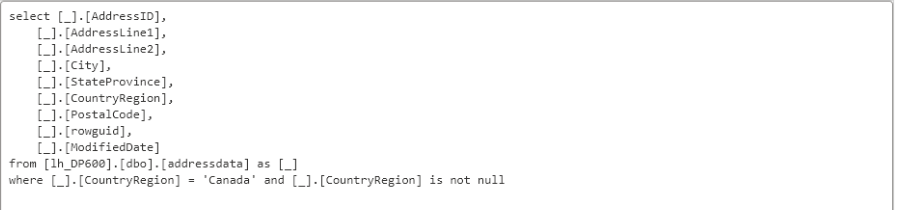
Un detalle: los archivos no pliegan. El plegado funciona con orígenes que entienden consultas, como las tablas del Lakehouse.
Lo que me llevo
- Compartir un Lakehouse no abre todo el área de trabajo.
- Crear un flujo no es ejecutarlo.
- El filtro, primero: que trabaje el origen.
¿A ti también te ha tocado pelearte con el punto y la coma decimal? Me encantará leerte.